16 de octubre de 2026 · por Geoff
El harness decide cuánto cuesta un token
Pon el mismo modelo en tres harness de agentes distintos y la cuenta se mueve de 1,5 a 2 veces en promedio y 5 veces en los extremos, mientras la tasa de éxito casi no cambia. El precio de un token ya no se fija donde dice la lista de precios.
versión para máquinas (en inglés): /machine/blog/harness-tax.md
Traducción al español; el original en inglés es la versión canónica.
El Informe de economía de tokens sigue dos precios desde septiembre: el precio de lista del modelo frontera más nuevo, que sigue subiendo, y el precio de una capacidad fija, que cae unas 13 veces al año. Los dos son reales. Ninguno es lo que paga un agente. Este ensayo es sobre el tercer precio, el que fija el harness, y sobre la gráfica nueva del informe que lo sigue.
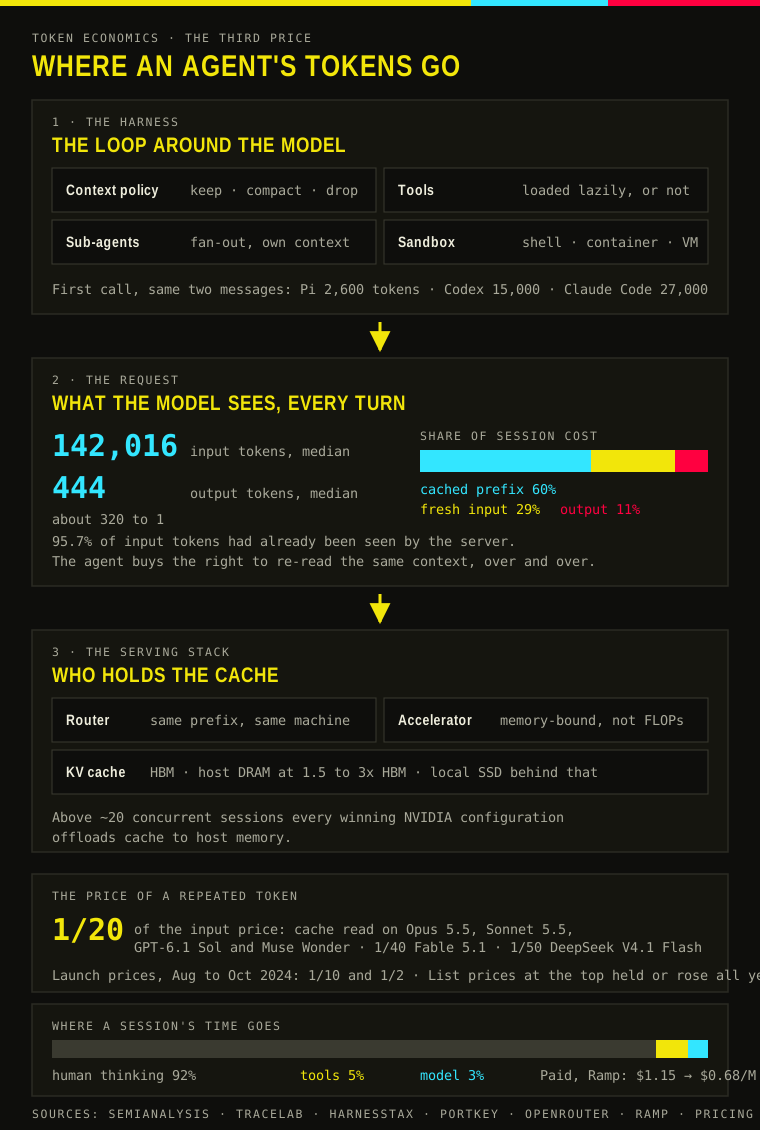
Mismo modelo, otra cuenta
Un harness es todo lo que envuelve la llamada al modelo: el bucle que decide qué hacer después, las herramientas que puede alcanzar, lo que guarda en contexto entre turnos, lo que descarta, cuántos subagentes lanza y dónde corre su código. Claude Code es un harness. Codex CLI es un harness. Cursor, Pi, Aider, OpenHands y los andamios que usa METR para medir horizontes de tiempo son todos harness. Un estudio de código fuente de once de ellos, publicado en julio, encontró que ninguno importa un framework general de agentes y ninguno usa búsqueda vectorial. Son bucles hechos a mano alrededor de grep, un editor de archivos y una terminal.
El mismo modelo se comporta muy distinto adentro de cada uno. Un estudio de septiembre de Berkeley y Arena pasó siete modelos por tres harness con las mismas tareas de código. El éxito se movió entre dos y cinco puntos. El costo por intento se movió de 1,5 a 2 veces en la media geométrica y 5 veces en el par más extremo: GPT-5.6 Luna resolvió una tarea de SWE-bench Lite por 3 centavos en Pi y por 15 centavos en Claude Code. La razón está en la primera llamada. Pi manda unos 2.600 tokens antes de que el usuario diga nada. Codex manda unos 15.000. Claude Code manda unos 27.000.
Los proveedores lo saben y ahora compiten en eso. Cursor recortó el costo en tokens de sus usuarios un 7% en septiembre solo con cambios al harness: un prompt de sistema reducido a un tercio, herramientas que se cargan solo cuando hacen falta, fallos de caché recortados una quinta parte. AWS afirma que su harness Strands corre los mismos modelos por 28% menos, una cifra que yo trataría como una dirección y no como un resultado hasta que salga el paper, porque AWS se calificó a sí misma. El propio escrito de Anthropic sobre una construcción de largo aliento es la ilustración más clara. La corrida simple de un solo agente tomó veinte minutos y 9 dólares, y la función central no funcionó. El harness completo de planificador, generador y evaluador tomó seis horas y 200 dólares, y funcionó. El harness es donde se va la plata, en las dos direcciones.
Qué compra un agente de verdad
Mira lo que ve la pila de servicio y la razón se vuelve obvia. SemiAnalysis publicó en agosto una traza de 393 sesiones de Claude Code. La solicitud mediana lleva 142.016 tokens de entrada y produce 444 de salida, una proporción de unos 320 a 1. Otro estudio de unas 4.300 sesiones de Claude Code y Codex encontró que el 95,7% de los tokens de entrada eran una repetición de un prefijo que el servidor ya había visto, y que los tokens de prefijo en caché eran el 59,5% del costo de una sesión, la entrada nueva el 29,2% y la salida el 11,2%.
Así que lo que un agente compra, una y otra vez, es el derecho a releer el mismo contexto. El precio de ese derecho no es el precio de entrada de la lista. Es el precio de lectura de caché, y ese número ha caído más rápido que cualquier otro en este mercado. Cuando el prompt caching salió en agosto de 2024, Anthropic y DeepSeek cobraban una décima del precio de entrada por un token en caché, y OpenAI, dos meses después, cobraba la mitad. Hoy Opus 5.5, Sonnet 5.5, GPT-6.1 Sol y Muse Wonder de Meta cobran una vigésima, Fable 5.1 cobra una cuarentava parte y DeepSeek V4.1 Flash una cincuentava. La gráfica nueva del informe sigue esta proporción por proveedor. Todos los proveedores con un producto de agentes la han recortado en los últimos doce meses.
El volumen siguió el mismo camino. En OpenRouter, los agentes superaron a los humanos en tokens en febrero de 2026 y para septiembre producían unas siete veces más. La porción de tokens agénticos servidos desde caché pasó de cerca del 60% en enero a poco menos del 90% en septiembre. El ejemplo que hace la propia OpenRouter: un millón de tokens agénticos a precios de Sonnet 5 cuesta 2,08 dólares sin caché y 0,51 con ella.
Por qué el precio de lista dejó de importar
Junta todo eso y sale el número que a mí me parece el más importante de este año. Ramp, que ve lo que las empresas pagan de verdad con sus tarjetas, reporta que el precio efectivo por millón de tokens tocó techo en 1,15 dólares en marzo de 2026 y estaba en 0,68 en agosto, una caída del 41%. En esos mismos meses el precio de lista de cada modelo frontera se mantuvo o subió. Nadie bajó un precio. La cuenta bajó de todas formas, porque los harness mejoraron en reusar contexto y los proveedores pusieron el reuso cerca de su costo marginal.
Esa es la tercera velocidad. El techo se mantiene, el piso se desploma, y el precio que de verdad se paga queda en la mitad, fijado por ingeniería y no por la lista de precios. También explica algo que el primer ensayo dejó colgando. Anthropic puede decir que Opus 5.5 cuesta 40% menos por tarea que Opus 5 con un precio por token más bajo y menos tokens por tarea; OpenAI puede decir que GPT-6.1 Sol hace trabajo casi de Astra por una quinta parte del precio de Astra. Esas son afirmaciones sobre el harness tanto como sobre el modelo. La forma más barata de abaratar un modelo es dejar de mandarle los mismos 140.000 tokens a precio completo.
Quién cobra
Si la cuenta la fija el reuso de caché, el margen se lo lleva quien tiene la caché. Para un proveedor eso es la caché KV en la memoria del acelerador y la memoria del host detrás, y el enrutamiento que manda el segundo turno de una sesión a la máquina que ya tiene el primero. El trabajo publicado en motores de inferencia este año es casi todo sobre esa capa: enrutamiento consciente del prefijo que vale dos o tres veces el round-robin, niveles de caché que se derraman a RAM y SSD cuando el acelerador se llena, transferencia de caché entre pares para que un prefijo se mueva entre máquinas en unos cientos de milisegundos en vez de recalcularse. SemiAnalysis encontró que por encima de unas veinte sesiones de agentes concurrentes toda configuración ganadora en hardware de NVIDIA descarga caché a la memoria del host, y que la tarjeta con 50% más memoria mantuvo el 91% del conjunto de trabajo en el chip donde la más pequeña mantuvo el 73%. El cuello de botella para los agentes es la capacidad de memoria, no el cómputo.
Para un comprador significa que el harness es una decisión de compras. Dos equipos con el mismo modelo y el mismo precio por puesto pueden pagar una cuenta 2 veces distinta según si su harness mantiene un prefijo estable, carga herramientas solo cuando hacen falta y compacta el contexto antes de que se desborde. Los enrutadores ya hacen esto al nivel de cada solicitud; Cursor reporta resultados de calidad frontera a un costo cerca de 60% menor mandando solo los turnos difíciles al modelo caro. Yo espero que la siguiente versión de eso sea un harness que se cobre por lo que ahorra.
Los contraargumentos
Uno de los contraargumentos es que las lecturas de caché son un descuento que los laboratorios pueden retirar. Ellos fijan la proporción y pueden subirla. No creo que lo hagan, porque la proporción sigue su propio costo: un token en caché les cuesta tiempo de memoria, no cómputo, y los laboratorios que corren los productos de agentes más grandes son los que más ganan con mantener el reuso barato. Se reporta que las suscripciones empaquetadas de Anthropic son cerca del 10% de sus ingresos y más del 40% de su cómputo de inferencia, lo cual solo se sostiene si los tokens en caché son casi gratis de servir.
El segundo es que los estudios de trazas son de agentes de código, y el código es el trabajo con más prefijo repetido que existe. Cierto, y el código también es donde está el volumen. Los agentes de código son la mayoría de los tokens agénticos en todo enrutador que publica un desglose, y los agentes siempre encendidos que lanzaron este otoño OpenAI, Meta y Google corren el mismo bucle sobre correos y navegadores en vez de repositorios. La proporción será menor para ellos. No tendrá forma de chat.
Qué mirar
Tres números en la página del informe dirán si esto se sostiene. La proporción de lectura de caché del modelo insignia más nuevo de cada proveedor: si sigue bajando a la mitad con cada generación, el precio efectivo sigue cayendo sin un solo recorte en la lista. La porción de tokens agénticos servidos desde caché en OpenRouter: está en poco menos del 90% y la distancia al 100% es la última ganancia barata. Y el precio efectivo por millón de tokens de Ramp, que es el único número público que mide lo que el harness, la caché y el enrutador juntos le hicieron de verdad a una cuenta.
Yo construí la rutina que actualiza este informe para poder ver moverse esos números sin leer los comunicados de prensa. El precio de lista es el número que los laboratorios quieren que mires. El harness decide lo que pagas.